Company Brain: qué es y cómo construirlo con IA
Un Company Brain es una memoria compartida de la empresa que reúne acuerdos, decisiones, procedimientos y sus fuentes para que personas y agentes de IA puedan utilizarlos en su trabajo. No describe un producto ni una arquitectura única: para construirlo necesitamos registrar esa información, organizarla, encontrarla cuando haga falta y mantenerla actualizada.
En esta guía veremos qué aporta frente a una wiki, cómo pueden combinarse RAG, herramientas y agentes, y por dónde empezaría con un equipo de desarrollo. Usaremos un mismo ejemplo: una reunión cambia lo acordado con un cliente, pero la tarea sigue diciendo otra cosa.
Tal vez has visto a alguien organizar sus notas en Obsidian, conectar ideas y construir lo que se llama un segundo cerebro, con grafos súper bonitos. La intención es sencilla: conservar lo que aprende y poder recuperarlo cuando lo necesite. Si además conecta esas notas a un asistente de IA, puede hacer preguntas sobre lo que tiene guardado.
Ahora imagina llevar esa idea a una empresa.
La información está repartida entre documentos, reuniones, conversaciones, tickets y repositorios. Una persona recuerda por qué se eligió cierta arquitectura. Otra sabe qué se le prometió a un cliente. Una tercera conoce un procedimiento que nunca se documentó. Cuando alguien necesita una respuesta, comienza la búsqueda: abrir herramientas, revisar mensajes y encontrar a quien se acuerda del asunto.
Hasta aquí podrías preguntarte: ¿esto no es una wiki con un chatbot encima?
Puede empezar así. Pero si queremos que un agente encuentre un acuerdo, lo relacione con una tarea y proponga actualizarla, necesitamos algo más que documentos.
La combinación depende del problema que quieras resolver. Consultar un procedimiento y detectar que alguien está trabajando con un acuerdo antiguo requieren cosas distintas. Vamos a verlas.
En esta guía
- Un ejemplo: una reunión cambia lo que pide una tarea.
- Nueve enfoques y cuándo pueden servir.
- Cómo combinar las piezas sin construirlas todas.
- Cómo empezar con un piloto pequeño.
- Cómo comprobar si el piloto sirve.
Del segundo cerebro personal al conocimiento empresarial
Cuando organizas tus propias notas, muchas cosas no necesitan explicación. Tú sabes a qué proyecto te refieres, qué significa una abreviación y por qué guardaste cierta idea.
En una empresa, otras personas y los agentes también necesitan entender esa información. Además, aparecen preguntas que trabajando solo podrías pasar por alto:
- ¿Quién puede consultar cada documento?
- ¿Qué ocurre cuando dos equipos tienen versiones distintas del mismo acuerdo?
- ¿Una frase en una reunión fue una propuesta o una decisión?
- ¿Quién puede aprobar el cambio?
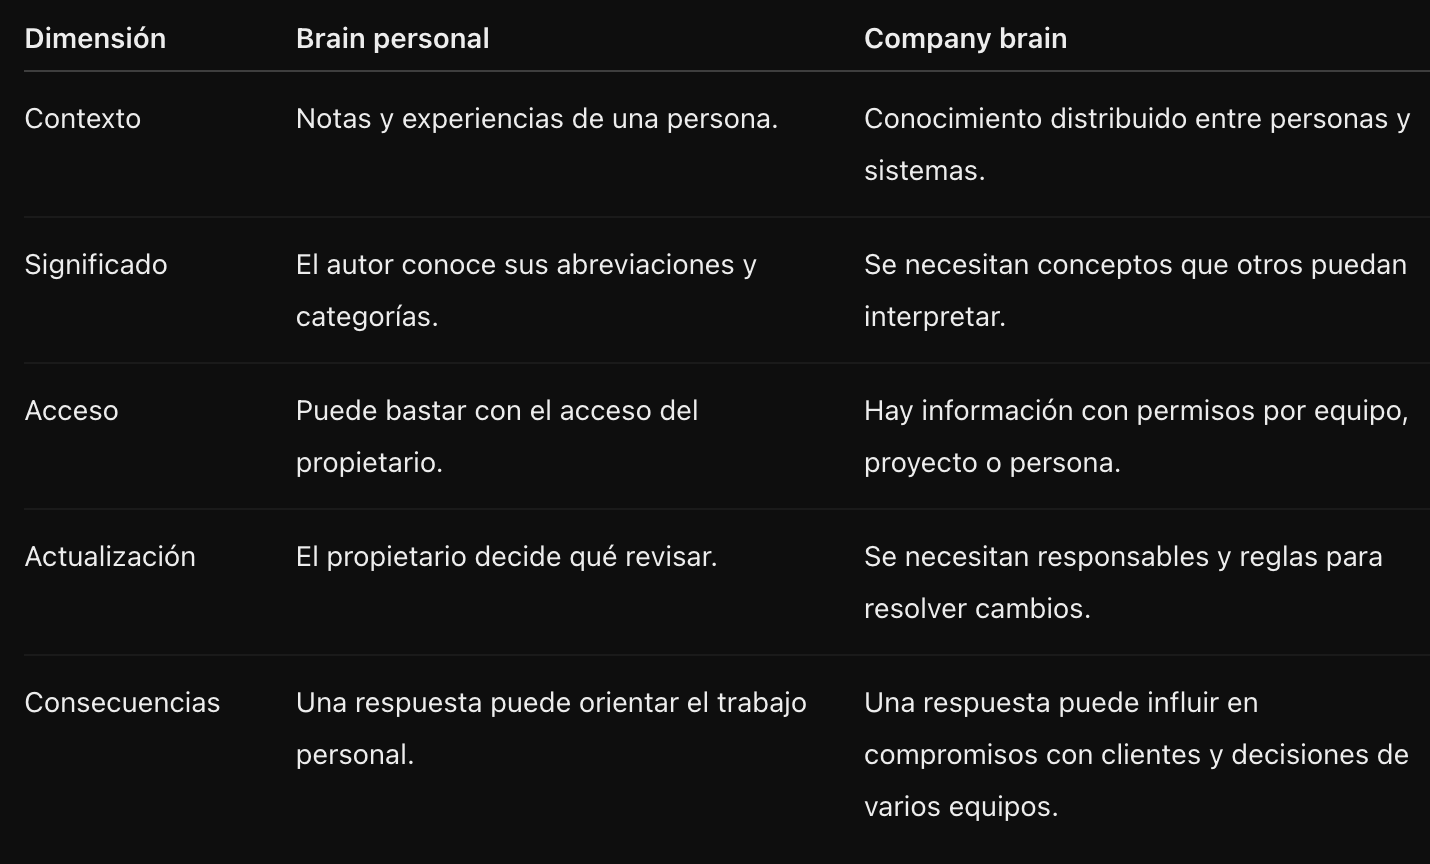
Usaré cerebro personal para referirme a la memoria de una persona y company brain para la memoria compartida de una organización. Son nombres útiles para explicar la idea, pero no describen una arquitectura técnica única.
Compartir esa memoria implica decidir quién mantiene la información, quién puede verla y cómo sabemos si un acuerdo sigue vigente.
Lo que sabemos y cómo trabajamos
Podemos distinguir dos clases de conocimiento:
- El declarativo describe lo que sabemos: quién es un cliente, qué necesita un proyecto o qué se acordó para una entrega.
- El procedimental describe cómo trabajamos: preparar una propuesta, revisar una arquitectura o resolver una incidencia.
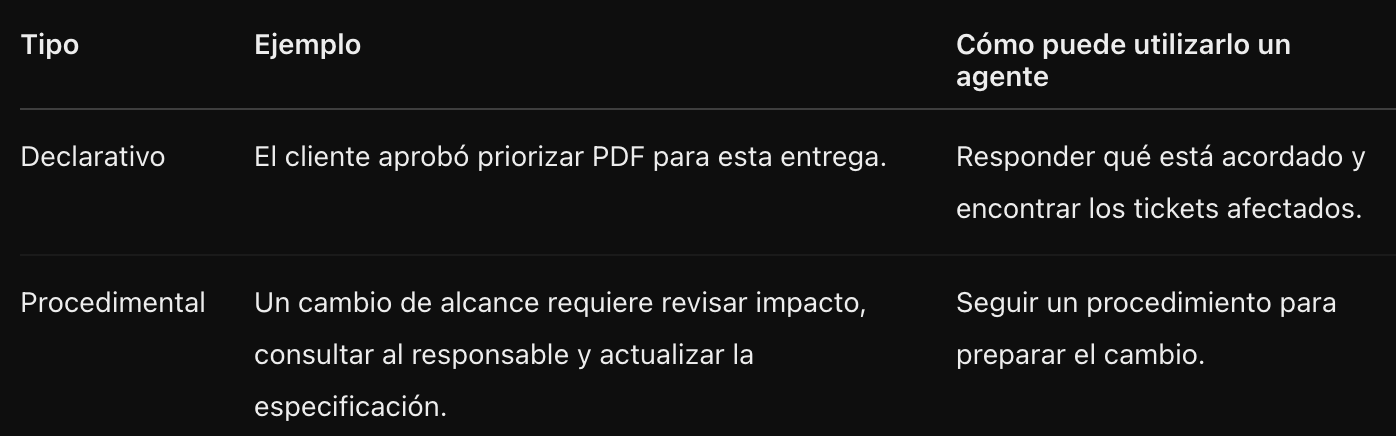
Los procedimientos pueden documentarse como guías, listas de comprobación o skills: instrucciones que un agente consulta para realizar una tarea. Describen cuándo usarlas, qué herramientas necesita y qué resultado esperamos. Los permisos para ejecutar acciones se aplican en el sistema, además de explicarse en las instrucciones.
Hacer la empresa legible para la IA significa documentar el trabajo de manera que el agente pueda entender de qué estamos hablando. Para un acuerdo, por ejemplo, necesitamos saber:
- Qué se decidió.
- A qué proyecto y entrega corresponde.
- Quién lo aprobó.
- En qué documento o conversación quedó registrado.
Mucha de esa información está en la cabeza de las personas o repartida entre conversaciones. El objetivo es llevarla a una memoria compartida que podamos consultar e incorporar los nuevos acuerdos a medida que aparecen.
Esa memoria también puede ayudar a mejorar los procedimientos. Si varias incidencias muestran que falta un paso, un agente puede proponer añadirlo y el equipo comprobar si el cambio resuelve el problema. Guardar más información hace crecer la memoria; mejorar cómo trabajamos requiere revisar y probar esos cambios.
Qué debería permitir un Company Brain
Imagina que un desarrollador tiene una tarea asignada: permitir que los usuarios descarguen reportes en CSV. En una reunión posterior, el equipo y el cliente acuerdan que para esa entrega necesitan PDF en lugar de CSV. Sin embargo, nadie actualiza la tarea y el desarrollador sigue trabajando con la instrucción anterior.
Un company brain podría detectar esa diferencia y avisar: “En esta reunión se acordó entregar PDF, pero la tarea todavía pide CSV”. También podría proponer un cambio en la descripción de la tarea para que el responsable lo revise.
Para conseguir algo así necesitamos conectar el acuerdo con el trabajo pendiente. Usaremos este ejemplo para explicar qué aporta cada enfoque.
Nueve enfoques que puedes combinar para construir un Company Brain
Yo lo ordenaría en estos nueve enfoques. Algunos sirven para guardar el conocimiento; otros, para encontrarlo, registrar cambios o actuar sobre él.
Cubren distintas partes del sistema y puedes combinarlos según lo que necesites. No hace falta construirlos todos.
1. Una wiki estructurada
Una wiki organiza la documentación en páginas: productos, proyectos, procesos y acuerdos. Las empresas llevan años utilizándolas. Las personas buscan las páginas y las leen para encontrar lo que necesitan.
Al conectar esa documentación a un asistente de IA, podemos hacer preguntas y recibir respuestas basadas en su contenido. La wiki conserva la documentación; el asistente facilita su consulta. Más adelante veremos cómo encuentra la información que necesita para responder.
El principal problema sigue siendo mantenerla actualizada. Si se acuerda cambiar CSV por PDF y nadie modifica la página, el asistente seguirá consultando el acuerdo anterior. Conectarla a una IA no hace que se actualice sola.
2. Un repositorio de conocimiento
Otra opción es guardar la documentación en archivos Markdown dentro de un repositorio Git. Markdown es el formato de los documentos; Git permite conservar su historial y revisar los cambios antes de incorporarlos.
Un agente puede leer esos archivos para consultar las decisiones técnicas, las especificaciones y los procedimientos del equipo antes de realizar una tarea. En nuestro ejemplo, el cambio de CSV a PDF podría incorporarse a la especificación junto con una referencia a la reunión.
Aquí aprovechamos el mismo flujo de revisión que usamos para el código. Encaja con equipos técnicos, aunque participar puede resultar difícil para quienes no utilizan Git. Y sigue dependiendo de que alguien, o un proceso autorizado, incorpore los nuevos acuerdos.
3. Recuperación de información con RAG
Bien, ya tenemos la documentación. ¿Cómo encontramos lo que sirve para responder una pregunta?
RAG significa Retrieval-Augmented Generation, o generación aumentada por recuperación. Consiste en buscar información y entregársela al modelo como contexto para que responda. Esa información puede venir de la wiki, del repositorio o de otros documentos, sin tener que volver a entrenar el modelo.
El trabajo original sobre RAG de Lewis y colaboradores es una referencia para entender la combinación de recuperación y generación; no define por sí solo la arquitectura de un company brain.
Una implementación habitual divide los documentos en fragmentos y prepara un índice para buscarlos. Ante “¿qué formato de reportes acordamos para esta entrega?”, el sistema busca los fragmentos relacionados, se los entrega al modelo y este genera una respuesta a partir de ellos. Por ejemplo, podría recuperar el resumen de la reunión donde se aprobó PDF.
La búsqueda puede ser por texto o por similitud de significado usando embeddings, representaciones numéricas del contenido. También podemos combinar ambos métodos. RAG no necesita obligatoriamente una base de datos vectorial: lo que lo define es recuperar información y utilizarla para generar la respuesta.
El resultado depende de las fuentes y de lo que encuentra la búsqueda. Si no recupera el último acuerdo, el modelo puede responder con información anterior. Si utilizamos un índice, también necesitamos mantenerlo actualizado cuando cambian los documentos.
4. Consulta directa a las herramientas
Pero no todo lo que necesitamos está en documentos. ¿Quién tiene asignado el ticket ahora? ¿Está terminado? ¿Qué dice su descripción?
Para responder estas preguntas, el agente puede consultar herramientas como GitHub o Linear mediante sus APIs o conectores. En nuestro ejemplo, consultaría el ticket para comprobar si todavía pide CSV.
Aquí también puede entrar MCP, un protocolo que permite poner herramientas y recursos a disposición del asistente. La introducción oficial a MCP explica ese papel de conexión. Un servidor MCP puede ofrecer acceso a una API o a un buscador de documentos. Por eso MCP y RAG pueden combinarse: MCP facilita el acceso y RAG describe el proceso de recuperar información para generar una respuesta.
Consultar directamente permite obtener lo que la herramienta tiene registrado en ese momento. Pero si el ticket sigue desactualizado, la API devolverá esa información desactualizada.
Puedes consultar la reunión y el ticket, pero eso no hace que coincidan. La reunión puede decir PDF y el ticket seguir pidiendo CSV. Todavía necesitas comparar ambos y decidir qué actualizar. Además, estas consultas dependen de los permisos y de que las herramientas estén disponibles.
5. Una memoria estructurada
Hasta aquí tenemos documentos y acceso a herramientas. También podemos guardar parte del conocimiento como registros con campos definidos. Una decisión tendría descripción, proyecto, fecha, estado, responsable y fuente.
Así podemos consultar “¿qué decisiones siguen pendientes de aprobación?” sin volver a interpretar todas las conversaciones. La IA puede ayudar a extraer esos registros. El acuerdo sobre PDF quedaría asociado al proyecto, a la entrega y a la reunión donde se aprobó.
El reto es representar correctamente lo ocurrido. “Podríamos entregar PDF” es una propuesta, no una aprobación. También necesitamos registrar cuándo un acuerdo reemplaza a otro, conservando el historial para entender qué cambió.
6. Un grafo de conocimiento
Además de guardar esos registros, podemos representar sus conexiones. Un grafo de conocimiento organiza entidades, como clientes, proyectos y tareas, y las relaciones entre ellas.
Una decisión modifica un requisito, ese requisito se implementa en varios tickets y esos tickets pertenecen a un proyecto. Recorrer esas conexiones permite responder: “¿qué trabajo se ve afectado por este cambio?”.
En nuestro ejemplo, el grafo conecta el acuerdo sobre PDF con el requisito de exportación y los tickets que lo implementan. La IA puede ayudar a identificar relaciones y consultar las que ya están registradas.
Esto está bueno cuando hay muchas dependencias entre proyectos y sistemas. La dificultad es mantener conexiones correctas. También podemos representar relaciones con tablas y claves foráneas; no necesitas una base de grafos para empezar. Una base especializada puede tener sentido cuando las consultas sobre esas conexiones lo requieren.
7. Procesamiento basado en eventos
Hasta aquí alguien tiene que preguntar. ¿Qué pasa si queremos detectar el cambio cuando llega la reunión?
Un evento registra que algo ocurrió: se guardó una nueva reunión, cambió un documento o se aprobó una decisión. Ese evento puede activar un proceso.
Por ejemplo, cuando llega el resumen de la reunión, el sistema identifica posibles acuerdos, busca el trabajo relacionado y comprueba si necesita actualización. Así puede detectar que el ticket sigue pidiendo CSV sin esperar a que alguien haga la consulta.
La IA interpreta el contenido y el sistema controla el procesamiento. Si la misma reunión llega dos veces, no queremos crear dos decisiones iguales ni proponer dos veces el mismo cambio. Si el proceso falla, necesitamos poder intentarlo de nuevo. También debemos distinguir los acuerdos nuevos de los antiguos para no reemplazar una decisión con información anterior.
8. Organización por áreas
Ventas, ingeniería y soporte pueden mantener documentación distinta, con responsables y permisos propios. Podemos organizar el brain por áreas para facilitar su mantenimiento y consultar el contexto necesario.
Una pregunta comercial puede necesitar acuerdos de ventas; una pregunta técnica, decisiones de ingeniería. Y algunas preguntas necesitan información de ambas.
Organizarlo así no significa que tengas que crear un agente para cada área. Puedes empezar separando la documentación y sus permisos.
El desafío aparece cuando el trabajo cruza equipos. Si ventas registra el acuerdo sobre PDF y ingeniería mantiene la tarea de CSV, necesitamos reconocer que ambos hablan del mismo proyecto y entrega.
9. Agentes que actúan sobre el conocimiento
Finalmente, podemos dar a los agentes herramientas para trabajar con ese contexto: preparar propuestas, crear tareas o modificar documentos.
En nuestro ejemplo, el agente encuentra el acuerdo sobre PDF y prepara una actualización del ticket para revisión. Puede avisar al responsable o, si tiene autorización, aplicar el cambio y comprobar que se guardó correctamente.
Aquí el company brain aporta el contexto y el agente sigue un procedimiento para actuar. Necesitamos definir qué acciones puede realizar, cuáles requieren aprobación y cómo registrar los resultados.
Los permisos también importan al consultar información. Aunque el agente no modifique nada, una respuesta podría revelar contenido de una reunión privada. El acceso debe controlarse tanto al recuperar información como al ejecutar acciones.
Cómo encajan entre sí
Una empresa puede conservar procedimientos en una wiki, utilizar RAG para consultarlos y conectar herramientas para comprobar el estado de las tareas.
Si además quiere detectar cambios como el de CSV a PDF, puede registrar decisiones en una memoria estructurada y procesar eventos cuando llegan nuevas reuniones. Después, un agente puede proponer una actualización del trabajo afectado. Las relaciones entre decisiones y tareas pueden vivir en tablas; para este ejemplo no necesitamos una base de grafos.
Yo partiría por una pregunta concreta: ¿qué queremos que este sistema nos ayude a resolver?
Si solo necesitamos consultar procedimientos, podemos empezar con documentación y una forma de buscarla. Si queremos detectar que una tarea contradice un acuerdo, también necesitamos registrar el cambio, relacionarlo con el trabajo y comparar ambas versiones.
No hace falta construir las nueve piezas de entrada. Puedes empezar pequeño y añadir otras cuando aparezca un problema que lo justifique.
También mediría cuántas llamadas al modelo hace cada proceso y cuánto contexto envía. Revisar cada cambio puede ser útil, pero también puede salir bastante caro.
Cómo empezar con un piloto pequeño
Yo escogería un proyecto y una pregunta: ¿qué formato de reporte se aprobó para esta entrega y qué tarea debe implementarlo? El objetivo inicial sería responder con evidencia, no actualizar tickets automáticamente.
- Delimita las fuentes. Empieza con una especificación, el resumen de una reunión y la tarea relacionada. Usa material ficticio para las primeras pruebas; antes de conectar datos reales, revisa quién puede consultarlos y qué proveedor los procesará.
- Registra la decisión. Conserva el proyecto, la entrega, el estado, el responsable y una referencia a la fuente. No conviertas una propuesta en una aprobación solo porque el modelo la redactó así.
- Recupera y compara. Busca el acuerdo vigente y consulta la tarea. Si no hay evidencia suficiente o las fuentes se contradicen, devuelve la duda para revisión, no una respuesta inventada.
- Propón antes de ejecutar. Muestra la diferencia entre el acuerdo y la tarea. Una persona revisa la evidencia y decide si corresponde modificarla.
Este sería un registro ficticio mínimo para el ejemplo:
id: decision-report-format
proyecto: portal-clientes-demo
entrega: exportacion-reportes
decision: Usar PDF en lugar de CSV
estado: aprobada
responsable: responsable-producto-demo
fuente: reuniones/demo-cambio-formato.md
tarea: tareas/demo-exportacion.md
sustituye: decision-report-format-csv
El campo estado registra una aprobación que ya debe existir en la fuente; escribir aprobada no crea esa aprobación. Las referencias también deben apuntar a documentos que el usuario tenga permiso para consultar. Este YAML es un ejemplo de contenido, no una implementación de permisos ni una base de datos lista para producción.
Para un equipo técnico, esos primeros registros pueden vivir en Markdown y revisarse con Git. Si el equipo no trabaja con repositorios, usa su herramienta de documentación habitual. Añade un índice, integraciones o eventos cuando la búsqueda y el mantenimiento manual dejen de resolver el problema.
Cómo comprobar si el piloto sirve
Antes de automatizar acciones, probaría estos casos y compararía cada respuesta con una revisión humana:
- Acuerdo claro: encuentra PDF, identifica la tarea que todavía pide CSV y cita la fuente correcta.
- Propuesta sin aprobar: no presenta una sugerencia de la reunión como decisión vigente.
- Información ausente o contradictoria: explica qué falta y qué necesita revisión.
- Documento restringido: un usuario sin acceso no recibe su contenido ni una respuesta que lo revele.
- Acuerdo reemplazado: utiliza la decisión vigente y permite rastrear cuál sustituyó.
Registraría respuestas correctas, errores de fuente, casos sin respuesta, tiempo de consulta y coste por consulta. Compararía el resultado con buscar esos mismos acuerdos manualmente. No daría permisos de escritura al agente mientras falle en identificar fuentes o respetar accesos.
Seguir aprendiendo
Si quieres documentar cómo debe trabajar el agente con ese contexto, puedes seguir con Claude Skills: cómo instalarlas, usarlas y crear tu primera skill. Para distinguir protocolos de conexión y comunicación, también tienes MCP vs. A2A.
En la academia puedes consultar la formación en español que estoy preparando para desarrolladores que quieren usar IA en su trabajo y construir aplicaciones con ella.
Publicado originalmente en https://gilbertsahumada.substack.com/p/que-es-un-company-brain-y-como-puedes .