# Qué mierda es Loop Engineering
> Solo estamos empaquetando los mismos conceptos de siempre
Canonical: https://www.gilbertsahumada.com/blog/que-mierda-es-loop-engineering/
Last updated: 2026-06-16
IA · AI Agents · Skills
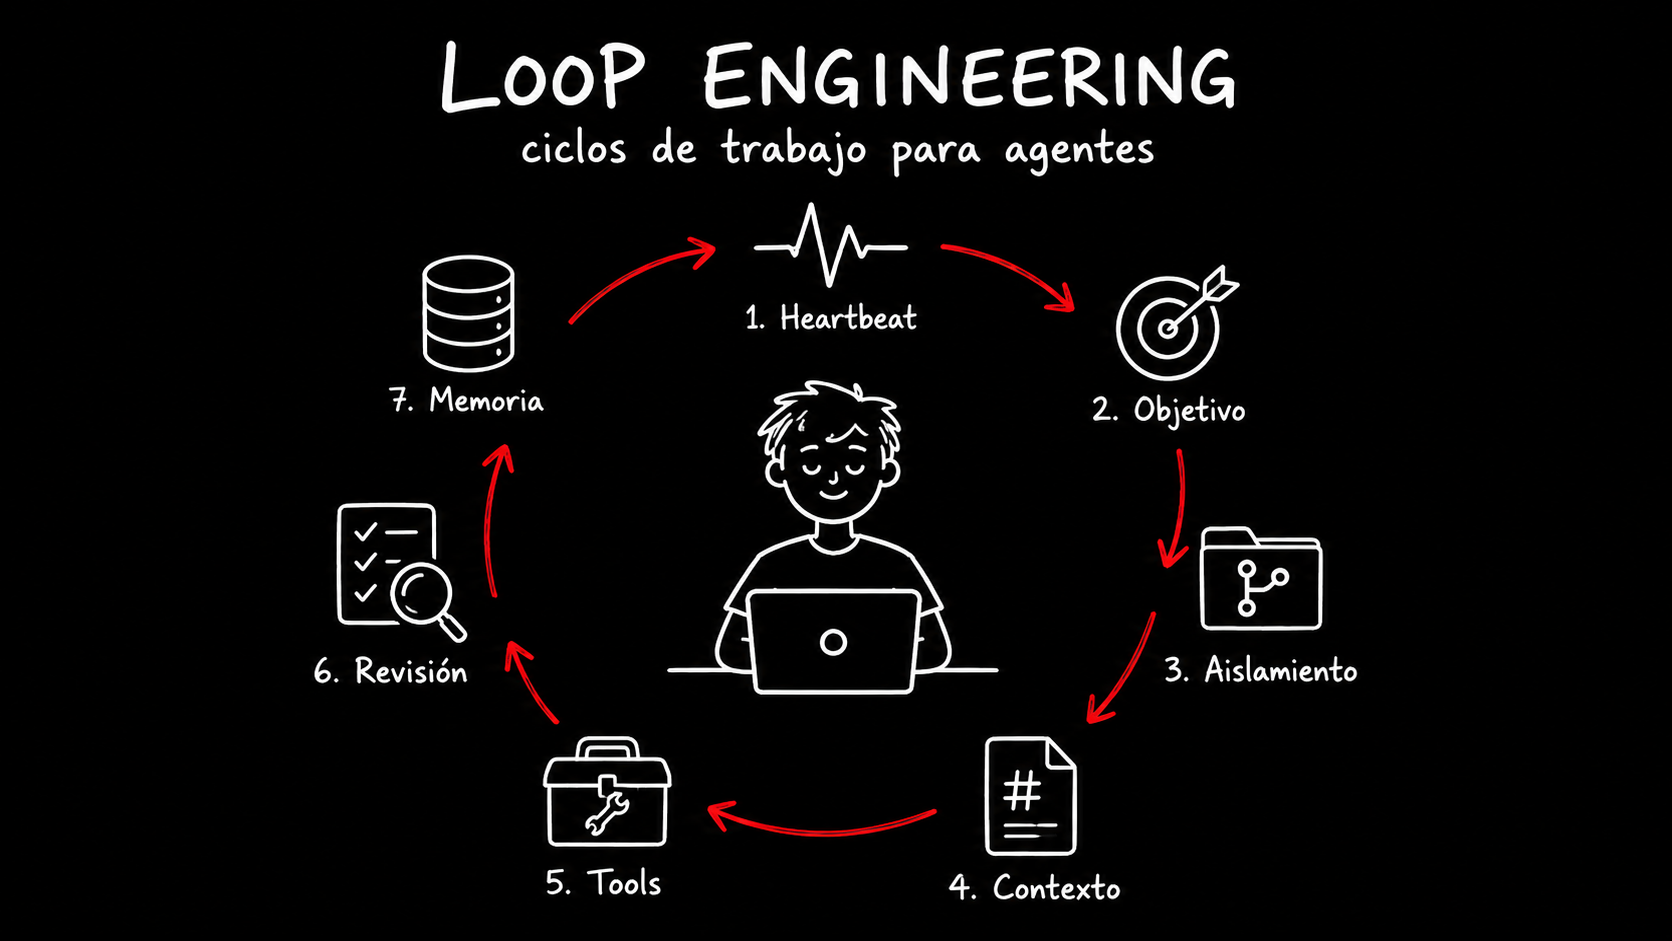
Todo se mueve muy rápido.
Cada semana aparece un concepto nuevo y, con algunas declaraciones de ciertos “referentes” de la industria, ahora empezó a sonar otro más: Loop Engineering.
Hace poco escribí sobre esto mismo en el blog de “[Los únicos 3 skills que necesitas](https://www.gilbertsahumada.com/blog/los-unicos-3-skills-que-necesitas/)”. La idea era simple: no vamos a poder aprender todas las herramientas, probar todos los modelos, instalar todos los plugins ni entender cada tendencia antes de que aparezca la siguiente.
Y este caso lo grafica perfecto.
En los últimos días leí todo lo que encontré sobre Loop Engineering. El post de Addy Osmani fue uno de los que más me sirvió para ordenar el concepto, pero no quería simplemente repetir la misma explicación. Quería entender si esta idea realmente aporta algo a la forma en que trabajo con agentes, Claude Code, Codex, specs, issues, worktrees, skills y todo este mundo raro que estamos armando.
Mi conclusión adelantada es esta: Loop Engineering no me parece una revolución. Me parece una forma útil de pensar sistemas de trabajo para agentes, siempre que no confundamos automatización con autonomía.
Algunas cosas me hicieron sentido.
Otras todavía las miro con escepticismo.
Así que decidí escribir esto con lo que me queda, con lo que no, y con algunas ideas que todavía estoy procesando.
Porque este concepto, como muchos otros, podría morir la próxima semana o, quién sabe, quedarse para siempre.
Durante los últimos años (2), trabajar con agentes de programación era aprender a escribir mejores prompts. Le dabas contexto al agente, esperabas la respuesta, corregías, volvías a pedir, revisabas otra vez. El agente era poderoso, pero tú seguías dándole al enter para permitir la ejecución, cierto?
O era yo nomás >:?
La promesa de Loop Engineering es mover esa dinámica a otra capa. En vez de empujar cada paso manualmente, diseñas un sistema que despierta, mira el estado del proyecto, decide si hay algo que hacer, usa contexto, trabaja en un espacio aislado, ejecuta herramientas, revisa resultados y recuerda lo que pasó para la siguiente iteración.
Suena bonito.
También puede ser una máquina carísima para quemar tokens y producir slop más rápido. Así que se precavido.
Por eso me interesa, pero como todo en la vida, prefiero probar, observar y después sacar mis propias conclusiones. Y como siempre, te invito a ti a hacer lo mismo, no me creas ni a mí ni a nadie, vive tu propia verdad.
## Esto no apareció de la nada
Mi primera reacción cuando leí “Loop Engineering” fue algo como:
¿Esto no es simplemente ponerle nombre fancy a cron jobs, CI pipelines y scripts con agentes?
Y sí, un poco sí.
Pero tampoco es exactamente lo mismo.
La buena noticia es que todos estos conceptos nuevos que aparecen en realidad, son conceptos, tecnologías y metodologías que hemos utilizado durante años, solo que empaquetadas, y como conjunto, se redefinen en un nuevo concepto.
Un cron job tradicional ejecuta algo que ya definiste de forma bastante cerrada. Corre un script, mueve datos, genera un reporte, revisa algo, manda una alerta. Es una automatización clásica.
La diferencia ahora es que dentro del ciclo puedes meter un agente que razona, explora, usa herramientas, revisa archivos, abre issues, modifica código, corre tests, pide revisión a otro agente y decide qué hacer después.
Ahí cambia la cosa.
Porque ya no estás automatizando solamente una tarea mecánica. Estás automatizando parte del proceso de trabajo de un ingeniero. Algo que he repetido innumerables veces es que en realidad lo que estamos haciendo al trabajar con IA es trasladar nuestro proceso de pensamiento a archivos markdown.
Y si diseñas mal ese proceso, no tienes un ingeniero virtual trabajando para ti.
Tienes una licuadora con acceso al repo.
## Mi definición simple
Para mí, Loop Engineering es diseñar ciclos de trabajo para agentes.
Un loop sabe cuándo despertar, qué intentar, dónde trabajar, qué contexto usar, qué herramientas tocar, cómo verificarse, qué recordar y cuándo detenerse.
Eso es todo.
Antes escribías:
“Arregla este bug …”.
Ahora podrías diseñar algo como:
“Cuando una especificación esté aprobada, genera las tareas, crea los issues correspondientes, abre un worktree por cada tarea, manda un agente a implementar, otro a revisar, corre las verificaciones necesarias y deja todo listo para revisión humana”.
Eso ya no es un prompt suelto.
Es un flujo de trabajo (workflow).
Y ahí está la parte interesante: el agente deja de ser solamente una conversación y empieza a convertirse en una pieza dentro de un sistema. Es otro ingeniero más.
## Las 7 piezas de un loop
Yo lo separaría en siete piezas.
No porque sea una ley universal, sino porque me ayuda a ordenar el concepto sin perderme en nombres de productos.
Y si, también me gusta el número 7.
### 1. Heartbeat
La primera pieza es el heartbeat.
Técnicamente podrías llamarlo trigger. No pasa nada.
Es lo que despierta el loop: una automatización, un cron, un hook, un evento de GitHub, un fallo de CI, un issue nuevo o incluso un comando manual.
Pero me gusta más heartbeat porque no habla solo de disparar una acción. Habla del pulso del sistema.
Es lo que hace que el loop vuelva a mirar el mundo y se pregunte:
* ¿Hay algo que hacer?
Sin heartbeat, tienes una ejecución manual. Con heartbeat, el sistema empieza a tener continuidad.
Y aquí se entiende por qué algunos dicen que estamos renombrando cron jobs. Porque sí, una parte del concepto vive ahí. Pero el heartbeat solo despierta el sistema. Lo importante es lo que pasa después.
### 2. Objetivo
La segunda pieza es el objetivo.
Aquí es donde muchos sistemas flaquean.
Un agente puede trabajar bastante, pero si no sabe exactamente cuál es el objetivo, empieza a improvisar.
Y los LLMs son bien buenos para improvisar.
A veces demasiado.
Un mal objetivo sería:
“Revisa si hay algo malo en el proyecto”.
Un mejor objetivo sería:
“Revisa los errores de CI de las últimas 24 horas, identifica si alguno viene de un cambio reciente, propone un fix en un worktree separado y detente solo cuando los tests relacionados pasen o cuando puedas explicar claramente por qué necesita intervención humana”.
La diferencia no está solamente en que el segundo prompt es más largo. La diferencia es que tiene dirección y condición de parada.
El loop necesita saber qué hacer, pero también cuándo parar. Si no tiene una condición clara de parada, puede seguir iterando, gastar tokens, tocar cosas que no debía y terminar con una solución que suena razonable pero que nadie le pidió.
Como decía Séneca:
> “Ningún viento es favorable para el que no sabe a qué puerto se dirige”.
El objetivo define la dirección.
La condición de parada define el control.
### 3. Aislamiento
La tercera pieza es el aislamiento.
Si tienes dos agentes editando el mismo checkout, en algún momento se van a pisar. Cambios mezclados, archivos tocados por ambos, conflictos raros y esa sensación hermosa de “ya no sé quién hizo qué”.
Aquí entran los [worktrees](https://youtu.be/lWHzzvruCMM).
Un worktree permite que cada agente trabaje en su propio espacio, con su propia rama, pero compartiendo el historial del repositorio. Así puedes tener un agente explorando una solución, otro revisando un bug y otro preparando una refactorización sin convertir tu carpeta principal en una sopa.
Esto no hace que el agente piense mejor.
Pero hace que el sistema sea más resiliente.
Y cuando empiezas a correr loops o varios agentes en paralelo, eso deja de ser opcional.
El aislamiento mejora la estabilidad del sistema donde el agente trabaja.
### 4. Contexto
La cuarta pieza es el contexto.
Un agente sin contexto rellena lo que no sabe con suposiciones. Y lo peor es que muchas veces esas suposiciones suenan coherentes.
El contexto no debería vivir solamente en tu cabeza. Tampoco debería vivir solamente en una conversación que se pierde después. Tiene que vivir en un lugar que el agente pueda leer cada vez que trabaja.
[Una skill ](https://www.gilbertsahumada.com/blog/como-utilizar-claude-skills-para/)puede decirle cómo correr tests, cómo crear un endpoint, qué carpetas no tocar, qué estilo seguir, qué errores ya se cometieron antes y qué cosas deben revisarse cuando se modifica cierta parte del sistema.
Para mí, una skill funciona como una transfusión de la metodología de trabajo y proceso de pensamiento del ingeniero hacia el agente. Esto evita que el agente parta desde cero en cada ejecución.
El contexto no es un complemento del loop. Es la diferencia entre un agente que sigue un proceso y uno que inventa.
### 5. Herramientas - Tools
La quinta pieza son las tools.
Un loop que solo puede leer y escribir archivos sirve para algunas cosas, pero se queda corto con otras.
Si quieres que el agente trabaje en un entorno real, necesita acceso a herramientas reales: GitHub, Linear, Slack, CI, bases de datos, logs, documentación, APIs internas, CLIs, staging, lo que sea que use tu equipo.
Aquí entran MCP, plugins, conectores e integraciones.
Esta es la diferencia entre un agente que te dice:
“Podrías abrir un PR con este cambio”.
Y
Un loop que realmente abre el PR, lo vincula con el issue, espera el resultado del CI y deja un resumen para que tú lo revises.
Si vamos a tratar al agente como alguien más dentro del equipo, entonces tiene que poder usar herramientas como alguien más del equipo. Pero darle herramientas a un agente sin límites claros es dejar a un mono con navaja.
No porque el agente sea malo.
Sino porque no entiende tu sistema como tú crees que lo entiende.
Las herramientas convierten al agente en alguien que puede actuar. Por eso también obligan a diseñar permisos, límites y verificación con más cuidado.
### 6. Revisión
La sexta pieza es la revisión.
Y para mí esta puede ser la más importante.
El mismo modelo y/o agente que escribió el código no debería ser el único encargado de decir si el código está bien. Ya tomó decisiones, ya justificó un camino, ya construyó una historia interna de por qué eso tiene sentido.
Separar creación de revisión es poderoso.
> Divide y vencerás
Un agente implementa. Otro revisa. Los tests verifican. El CI confirma. Y tú sigues siendo la última capa de criterio a la hora de implementar.
Sí amigo, hay que hacerse responsable de algo todavía.
Aquí entran subagentes, reviewers, comandos de verificación, tests, linters, snapshots, evaluaciones y cualquier mecanismo que obligue al loop a demostrar que lo que hizo funciona.
También aquí entran cosas como `/goal`, `/loop`, hooks, advisors y todas estas primitivas que están apareciendo en Claude Code, Codex y otras herramientas. De hecho el concepto de reviewer y verifier me los robé de Claude Code y andan bastante bien.
Un loop sin revisión eres tú autoevaluándote y poniéndote un 7 en todo.
En Chile el 7 es la nota máxima, btw.
Un loop con revisión es pedirle al que te cae mal que revise si realmente hiciste bien la pega.
La revisión es lo que evita que el loop sea solo velocidad. Es lo que empieza a convertirlo en un sistema más confiable.
### 7. Memoria
La séptima pieza es la memoria.
Y suena simple, pero es la que permite que el loop no parta desde cero cada vez.
El modelo olvida entre ejecuciones.
* El repositorio no.
* Un archivo Markdown no.
* Un issue no.
* Un PR no.
* Un log de decisiones no.
La memoria guarda qué se intentó, qué falló, qué quedó pendiente, qué se decidió y qué debería pasar después.
Sin memoria, cada ejecución empieza desde 0.
Con memoria, el loop puede continuar.
Puede decir:
* “Ayer intenté arreglar esto, pero falló por este test”.
* “Este bug ya apareció antes”.
* “Este PR quedó pendiente de revisión humana”.
* “Este archivo no se debe tocar sin actualizar esta otra parte”.
No tiene que ser algo sofisticado al principio. Puede ser un archivo markdown, un issue bien escrito, una carpeta con reportes o cualquier lugar fuera de la conversación donde quede registrado qué pasó.
Porque si todo vive solo dentro del contexto del modelo, tarde o temprano se pierde.
La memoria es lo que convierte una ejecución aislada en un proceso contínuo.
## Lo que sí usaría hoy
Yo no partiría usando loops para que un agente me reescriba medio sistema mientras duermo.
Partiría por cosas bastante más aburridas.
* Revisar fallos de CI y dejar un diagnóstico.
* Revisar issues antiguos y clasificarlos.
* Preparar borradores de fixes en worktrees separados.
* Revisar PRs pequeños contra una checklist del proyecto.
* Generar issues desde una especificación aprobada.
* Actualizar documentación cuando cambia una API.
Ese tipo de tareas tiene algo importante: son repetitivas, tienen contexto, tienen límites y pueden verificarse.
Ahí un loop puede tener sentido.
En cambio, si le dices:
“Mejora la arquitectura del proyecto”.
Buena suerte.
Quizás te entregue algo impresionante.
Quizás te rompa tres capas del sistema con una sonrisa.
## El loop no piensa por ti
Entiende esto.
Si el agente puede ejecutar más, tú tienes que diseñar mejor.
Mejor contexto, mejores límites, mejores objetivos, mejor memoria, mejor revisión y mejor criterio.
Antes el trabajo era escribir mejores prompts, turno por turno. Ahora empieza a ser diseñar mejores sistemas de trabajo alrededor del agente.
Yo sigo aplicando lo anterior, al final, terminan siendo distintas maneras de trabajar, y mientras mas dominemos y experimentemos, mas herramientas tenemos para el día dependiendo del contexto.
Cuando diseñas un loop, estás creando un sistema que puede actuar muchas veces, en paralelo, con acceso a herramientas reales y con capacidad de modificar tu proyecto.
Eso no es menor.
Dos personas pueden construir el mismo loop y obtener resultados completamente distintos.
Una lo usa para avanzar más rápido en un sistema que entiende profundamente.
La otra lo usa para evitar entender el sistema.
El loop no entiende la diferencia.
Tú sí.
## Con qué me quedo
Me quedo con estas siete piezas:
1. Heartbeat.
2. Objetivo.
3. Aislamiento.
4. Contexto.
5. Herramientas.
6. Revisión.
7. Memoria.
Si falta una de esas piezas, el sistema empieza a cojear.
Si las juntas bien, puedes automatizar partes reales del trabajo.
Si las juntas mal, solo construyes una máquina cara que es cero aporte.
Así que sí, prueba loops.
* Pero pruébalos con cuidado.
* Mide tokens.
* Empieza por tareas pequeñas.
* Usa worktrees.
* Escribe skills.
* Define bien tus specs.
* Guarda memoria fuera del contexto.
Y, sobre todo, no uses esto para dejar de pensar.
Porque el loop no sabe si estás acelerando un trabajo que entiendes o escapando de uno que no quieres entender.
Tú sí.
[Publicado originalmente en](https://gilbertsahumada.substack.com/p/que-mierda-es-loop-engineering)
## Related
* [La IA no está subsidiada…](https://www.gilbertsahumada.com/blog/la-ia-no-esta-subsidiada/)
* [¿De verdad me gustaba programar?](https://www.gilbertsahumada.com/blog/la-ia-el-codigo-y-quienes-somos-ahora/)